Анализ корпоративной базы знаний
Работа началась с анализа того, где и в каком виде хранятся знания команды ГрафТех. Архитектурные решения, требования к программному коду и внутренние практики были распределены между технической документацией, wiki, регламентами и репозиториями исходного кода.
Для каждого типа источника требовалось определить способ подключения, правила обработки и роль в дальнейшем поиске. Документация может описывать общую архитектуру системы, тогда как репозиторий содержит ее фактическую реализацию, поэтому объединять такие материалы в один неструктурированный массив было бы недостаточно.

На этом этапе был согласован состав подключаемых источников и спроектирована общая модель корпоративной базы знаний, в которой каждый фрагмент информации сохраняет связь с исходным документом, файлом или разделом репозитория. Для такого ИИ-проекта принципиально важно было не просто подключить языковую модель, а выстроить управляемый контур корпоративных знаний.
Проектирование RAG-архитектуры
Основой решения стал RAG-подход (Retrieval-Augmented Generation), при котором языковая модель формирует ответ не только на основании собственных знаний, а получает релевантный контекст из внутренней базы ГрафТех.
Архитектура построена как последовательный контур обработки корпоративных знаний. Сначала система получает материалы из подключенных источников, затем разбивает их на смысловые фрагменты и сохраняет необходимые метаданные. После этого данные индексируются и становятся доступными для поиска. Когда пользователь задает вопрос, система находит наиболее релевантные материалы, передает их языковой модели в качестве контекста и формирует итоговый ответ со ссылкой на первоисточник.
Такой подход позволяет использовать искусственного ассистента как инструмент работы с корпоративной экспертизой, а не как универсальный чат-бот, который отвечает без учета внутренних стандартов компании.
Извлечение информации из разных источников
Для подключения базы знаний был реализован слой загрузки данных из согласованных источников. Его задача — привести разнородные материалы к общей модели, с которой затем может работать система поиска.
Документ, wiki-страница и файл исходного кода имеют разную структуру. Поэтому этап получения данных отделен от последующей обработки: это позволяет подключать новые источники без перестройки всей серверной логики агента и развивать решение по мере роста корпоративной информационной среды.
При этом интеллектуальная логика не привязана к одному источнику и может расширяться вместе с внутренними системами компании.
Разбиение материалов и сохранение контекста
После загрузки материалы разбиваются на смысловые фрагменты, пригодные для поиска и последующей передачи языковой модели.
Для технической документации это особенно важно. Если индексировать файлы целиком, найденный результат может оказаться слишком большим и содержать нерелевантные разделы. Если дробить данные слишком мелко, теряется архитектурный или программный контекст.
Поэтому вместе с содержанием каждого фрагмента сохраняются метаданные: источник, путь до материала, раздел, версия или дата и другая информация, необходимая для идентификации первоисточника. Эти данные затем используются при формировании ссылок в ответах агента.
Векторная индексация корпоративных знаний
Для смыслового поиска текстовые фрагменты преобразуются в числовые представления, которые позволяют системе сравнивать их не только по совпадению слов, но и по содержанию.
Разработчик может сформулировать вопрос иначе, чем соответствующее правило записано во внутреннем регламенте, но система все равно способна найти подходящий фрагмент по смыслу. Полученные представления сохраняются в специализированном хранилище и используются поисковым контуром агента.
Гибридный поиск по документации и коду
Одного семантического поиска недостаточно для технической базы знаний. В репозиториях встречаются сущности, для которых критичны точные совпадения: названия классов и методов, имена сервисов, идентификаторы модулей, пути и названия файлов.
Поэтому поисковый слой предусматривает полнотекстовый и/или гибридный поиск, который сочетает семантическое сопоставление с ключевыми словами. Такой подход позволяет одинаково эффективно работать и с естественными вопросами, и с точными техническими запросами.
Ответы с обязательной ссылкой на источник
Одним из ключевых требований ГрафТех была проверяемость ответа. Для корпоративной разработки недостаточно получить убедительно звучащий текст: специалист должен понимать, на каком внутреннем документе, файле или разделе репозитория он основан.
После поиска релевантные фрагменты передаются LLM в качестве контекста. Агент формирует ответ на их основе и возвращает пользователю ссылку на первоисточник. Если релевантной информации в базе нет, серверная логика должна корректно обработать такую ситуацию, а не выдавать неподтвержденный внутренними материалами ответ.
Такой механизм делает разработку ИИ-агентов пригодной для работы с техническими знаниями, где цена правдоподобного, но неверного ответа очень высока.
Консультирование по архитектуре проектов
Первый основной сценарий агента — вопросы по архитектуре внутренних проектов. Разработчик может обратиться к системе на естественном языке и уточнить, какой архитектурный подход используется в конкретном проекте, где описано взаимодействие компонентов, какие ограничения предусмотрены для модуля или какой внутренний регламент применяется в определенной ситуации.
Агент выполняет поиск по базе знаний, выбирает релевантные материалы и формирует консолидированный ответ. Пользователь начинает не с поиска нужного файла, а непосредственно с задачи, которую хочет решить.
Объяснение программного кода с учетом внутренних стандартов
Второй основной сценарий связан с программным кодом. Пользователь может передать агенту фрагмент и запросить его объяснение.
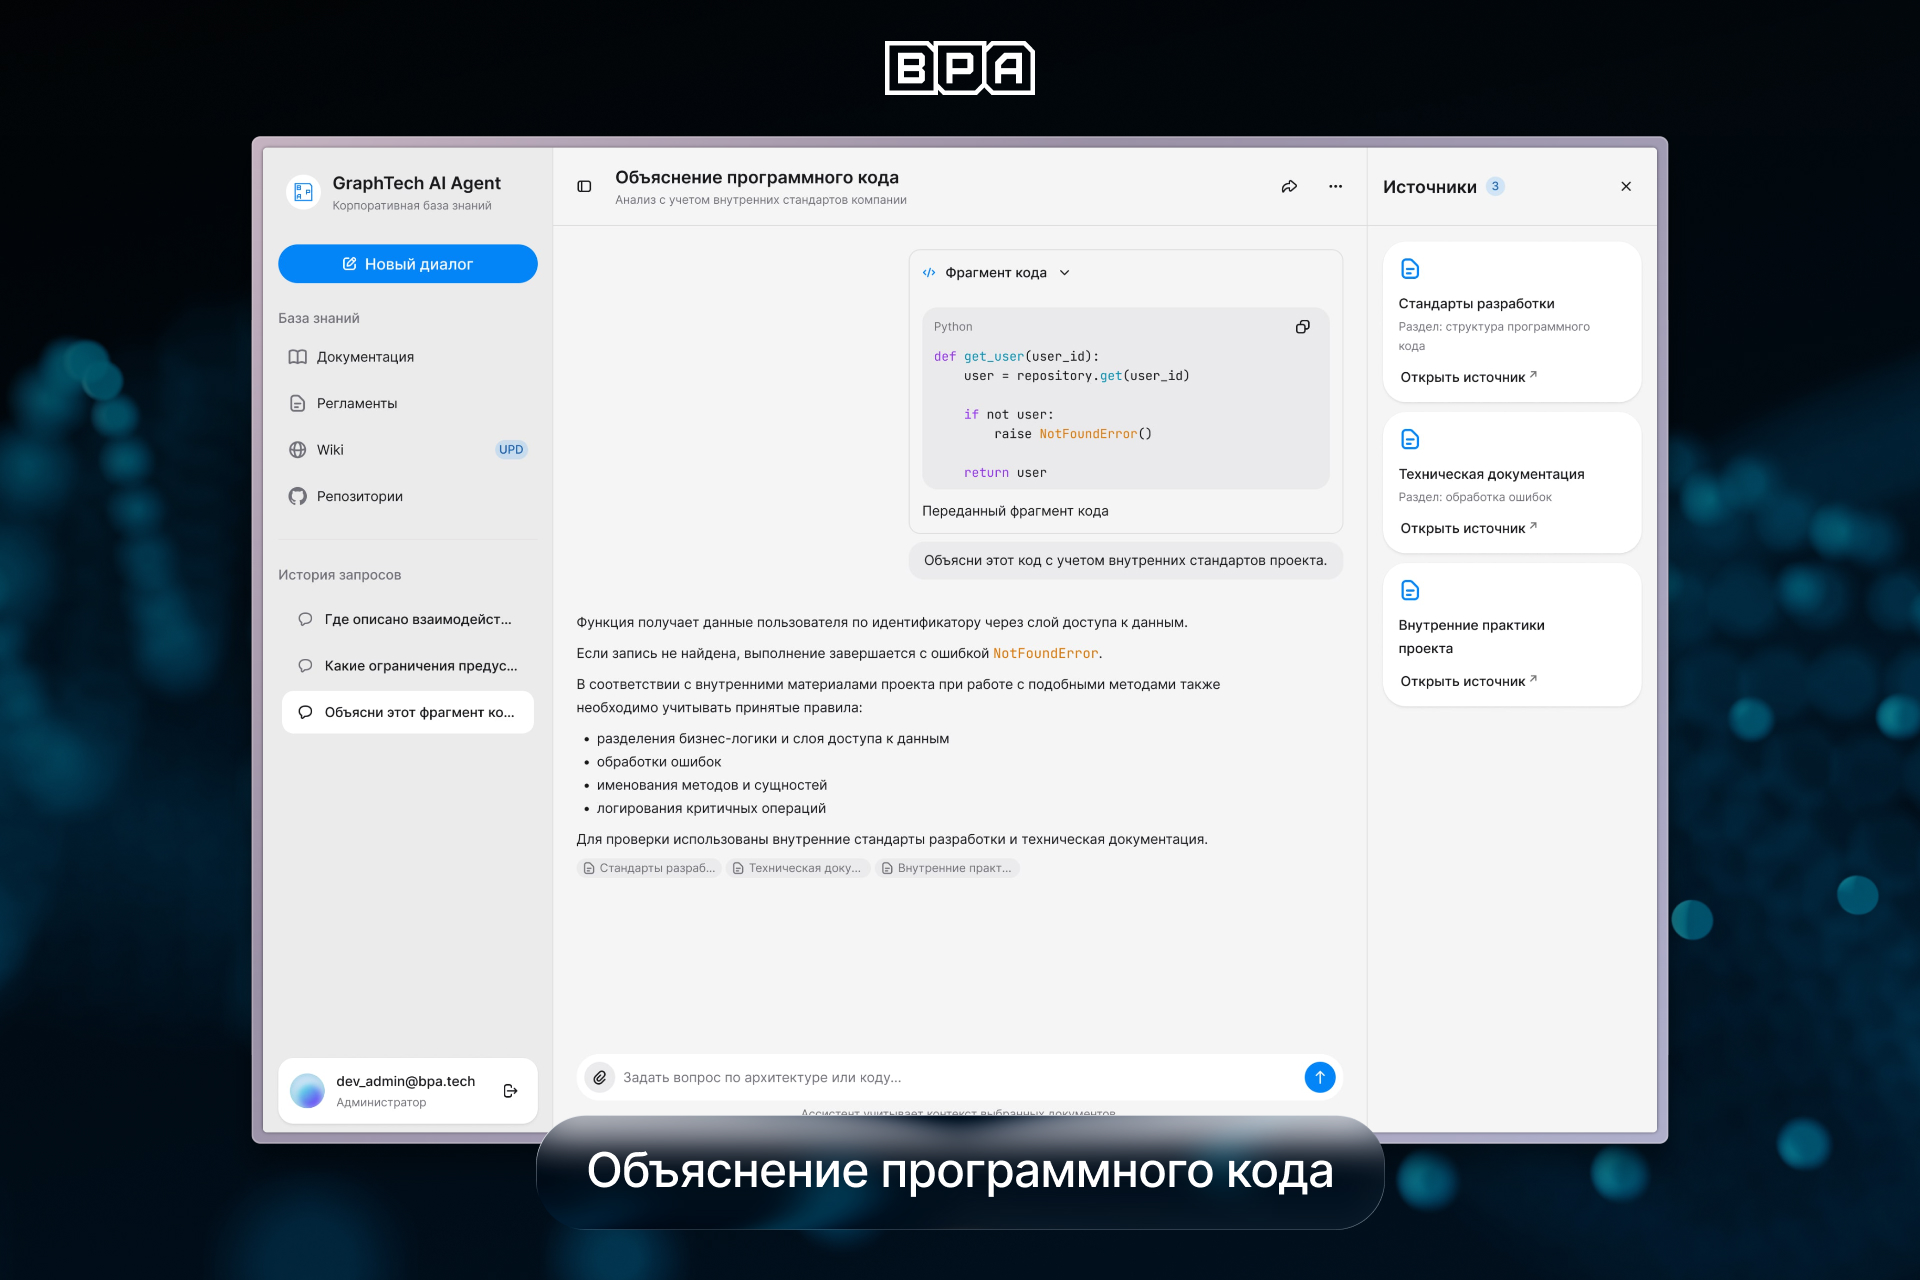
В отличие от универсальной публичной модели, агент работает в контексте внутренних материалов ГрафТех и может учитывать принятые стандарты и практики компании. Его задача — не только объяснить, что технически делает код, но и сопоставить его с конкретной средой разработки.
Это особенно полезно при подключении специалистов к существующим проектам: вместе с объяснением реализации сотрудник получает доступ к внутреннему контексту, на котором эта реализация основана.
Обновление базы знаний без остановки сервиса
Корпоративная база знаний не является статичной. Документация меняется, появляются новые регламенты, обновляются репозитории и создаются новые архитектурные решения.
Поэтому серверная логика предусматривает загрузку новых материалов, обновление существующих данных и повторную индексацию. Поддерживается инкрементальный сценарий, при котором измененные источники можно переиндексировать без полной остановки сервиса.
Это позволяет знаниям агента развиваться вместе с внутренней информационной средой компании и снижает риск работы с устаревшими материалами.
API как независимый слой интеграции
Результатом проекта стал не чат, жестко связанный с одним пользовательским интерфейсом, а независимый серверный сервис. Для взаимодействия с агентом выполнена разработка API, через который клиентское приложение может передавать вопросы, получать ответы и ссылки на источники, а также отправлять код на объяснение.
Такое решение позволяет в дальнейшем интегрировать агента с корпоративным веб-приложением, мессенджером, внутренним порталом или IDE-плагином. С точки зрения разработки программного обеспечения для бизнеса это снижает связанность компонентов: интеллектуальный backend можно развивать независимо от клиентского интерфейса.
Отдельный API также упрощает дальнейшую разработку интеграций с внутренними сервисами Заказчика без изменения логики самого RAG-контура.
Для серверного решения предусмотрено базовое логирование запросов и ответов. Оно необходимо для технической эксплуатации и дальнейшего улучшения качества агента.
Защищенный контур работы с корпоративными данными
Поскольку агент работает с внутренней документацией, программным кодом и архитектурой проектов компании, решение спроектировано с учетом требований к конфиденциальности и дальнейшему росту. Обработка данных выполняется в согласованном защищенном контуре, без передачи корпоративных материалов сторонним сервисам вне утвержденной инфраструктуры. При этом архитектура позволяет подключать новые источники, увеличивать объем базы знаний и число пользователей без полной переработки системы.